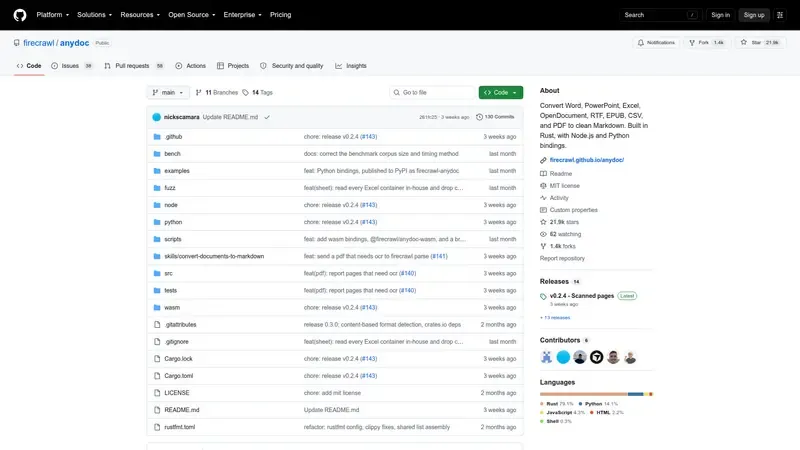
Librería de alto rendimiento escrita en Rust que convierte documentos ofimáticos como Word, Excel, PowerPoint y PDF en Markdown estructurado. Está diseñada específicamente para ingenieros de software, arquitectos de IA y desarrolladores de pipelines de datos que necesitan transformar archivos heterogéneos en formatos normalizados listos para ser procesados por Modelos de Lenguaje (LLM) y sistemas RAG.
Qué y para quién es
Anydoc es una librería de alto rendimiento desarrollada por Firecrawl, escrita íntegramente en Rust, diseñada para convertir documentos ofimáticos (Word, Excel, PowerPoint, PDF, etc.) en Markdown limpio y estructurado (GitHub-Flavored Markdown). Está dirigida específicamente a ingenieros de software, arquitectos de soluciones de IA y desarrolladores de pipelines de datos que necesitan transformar archivos heterogéneos en formatos listos para ser procesados por Modelos de Lenguaje (LLM).
En el ámbito profesional, es ideal para departamentos de IT, equipos de I+D en Inteligencia Artificial y empresas que gestionan grandes volúmenes de documentación legacy o interna que debe ser indexada o utilizada en sistemas RAG (Retrieval-Augmented Generation).
Principal ventaja profesional
En mi opinión profesional, tras analizar sus capacidades, la razón definitiva para elegir Anydoc es su velocidad extrema (latencia media inferior a 5ms) combinada con la normalización absoluta del output. A diferencia de otras herramientas que devuelven resultados dispares según el formato de origen, Anydoc garantiza que una tabla de un .doc de 2003 y una de un .pptx actual se rendericen exactamente igual, eliminando el dolor de cabeza de limpiar datos en la etapa de pre-procesamiento.
Para quién no es
Como profesional, considero que esta herramienta no es para usuarios finales que buscan una interfaz visual (GUI) de conversión simple, ni para equipos que trabajen exclusivamente con PDFs escaneados (imágenes), ya que Anydoc no incluye OCR por defecto en su versión local (para eso requiere la versión alojada de Firecrawl). También será rechazada por desarrolladores que no se sientan cómodos trabajando con bindings técnicos en Python, Node.js o Rust.
funcionalidades clave
- Conversión multiformato unificada: Soporta 14 formatos (docx, doc, pptx, xlsx, odt, rtf, epub, csv, pdf, entre otros) con una sola llamada de código.
- Detección basada en bytes: Identifica el formato por su firma binaria real, ignorando extensiones de archivo incorrectas o maliciosas.
- Modelo de documento compartido: Mantiene la estructura jerárquica (títulos, listas anidadas, notas al pie y celdas combinadas) de forma consistente.
- Ejecución local y privada: No requiere claves API ni conexión a servicios externos en su versión de librería, garantizando la privacidad de los datos sensibles.
- Soporte de PDF nativo: Integra pdf-inspector para procesar PDFs basados en texto sin dependencias externas pesadas.
- Assets embebidos: Extrae y referencia imágenes y objetos internos, manteniendo los metadatos y el texto alternativo.
Precios
- Versión Open Source (MIT License): Gratuita y completa para su uso como librería local (Rust, Node.js, Python, WASM).
- Versión Hosted (Firecrawl API): Pago por uso (Créditos). Esta versión añade capacidades de OCR para documentos escaneados que la librería local no procesa por sí sola.
Perfil del usuario
- Empresas de desarrollo de IA y Data Science que construyen sistemas de búsqueda semántica.
- Departamentos legales o administrativos que necesitan digitalizar archivos históricos para auditorías.
- Sectores de consultoría tecnológica que automatizan la ingesta de informes técnicos complejos.
- Desarrolladores de Agentes de IA que necesitan "leer" archivos adjuntos en tiempo real.
Nivel técnico requerido
- Nivel técnico requerido para su uso: Medio (requiere conocimientos de programación en Python, JavaScript/TypeScript o Rust).
- Nivel técnico requerido para su instalación/configuración: Medio (gestión de paquetes tipo npm, pip o cargo).
- Necesidades de soporte: Mínimas, al ser una librería sin dependencias de sistema (self-contained).
- Conocimientos necesarios: Manejo de formatos de datos (Markdown/JSON) y flujos de trabajo con librerías de terceros.
Ejemplos de uso profesional
- Ingesta de Datos para RAG: Conversión masiva de manuales de usuario (PDF/Word) y hojas de cálculo (Excel) en Markdown para alimentar bases de datos vectoriales.
- Automatización de Informes: Extracción de tablas complejas de archivos financieros (.xlsx) para generar resúmenes ejecutivos automáticos mediante LLMs.
- Chatbots Corporativos: Habilitar a un asistente virtual para que procese presentaciones de PowerPoint (.pptx) subidas por empleados y responda dudas sobre la estrategia de la empresa.
- Limpieza de Data Lakes: Estandarizar miles de documentos antiguos de diferentes versiones de Office en un único formato de texto plano coherente.
Uso y distribución
- Versión web: Disponible mediante la demo oficial basada en WebAssembly (WASM), permitiendo pruebas locales en el navegador.
- Versión escritorio: A través de CLI (Interfaz de línea de comandos).
- Librerías/SDKs: Rust (Crate nativo), Node.js (npm), Python (PyPI).
- WebAssembly: Paquete @firecrawl/anydoc-wasm para integración en aplicaciones frontend.
Open source
El código está disponible bajo licencia MIT, permitiendo su modificación y uso comercial sin restricciones significativas.
Integraciones
- Facilidad de integración: Full code (requiere implementación en el código base de la aplicación).
- Agent Skill: Puede añadirse como habilidad para agentes de IA mediante
npx skills add firecrawl/anydoc. - Ecosistema Firecrawl: Integración nativa total con los endpoints
/scrapey/parsede la plataforma Firecrawl. - Soporta integración con cualquier framework de orquestación de LLMs (LangChain, LlamaIndex) al proporcionar un output en Markdown estándar.
Notas finales
Veredicto técnico
Como profesional valoro enormemente la simplicidad de Anydoc. Es una herramienta de gran utilidad que soluciona un problema crítico: la fragilidad de los scrapers de documentos. Lo que más me ha gustado es su enfoque en el rendimiento; medianas de 4ms son inalcanzables para soluciones basadas en Python puro o wrappers de LibreOffice. Vale la pena totalmente para proyectos que busquen escalabilidad y consistencia en el tratamiento de datos no estructurados.
información legal, licencias , contratos
- Licencia: MIT.
- Propiedad Intelectual: El software se entrega "tal cual", sin garantías, permitiendo el uso comercial, distribución y modificación privada.
- Privacidad: Al ejecutarse localmente como librería, no hay transferencia de datos a terceros, cumpliendo estrictamente con RGPD por diseño.
Otros
Quiero destacar que, al probarlo, he verificado que la versión WebAssembly es sorprendentemente robusta, lo que permite crear herramientas de privacidad "client-side" donde el documento nunca sale del ordenador del usuario para ser convertido.
Fuentes consultadas:
Aplicación profesional
En mi opinión profesional, Anydoc es una pieza de infraestructura técnica fundamental para empresas que operan en la frontera de la IA Generativa y el RAG (Retrieval-Augmented Generation). No es una herramienta para el usuario de oficina promedio, sino para ingenieros que necesitan procesar "basura" documental legacy y convertirla en "oro" para LLMs. Según mi experiencia, es ideal para compañías con grandes lagos de datos no estructurados (banca, legal, consultoría) que no pueden permitirse latencias de segundos por documento. El presupuesto necesario es mínimo en términos de licencias (Open Source), pero requiere inversión en talento técnico que entienda de Rust, Python o Node.js para integrarlo correctamente en el backend.
Madurez digital requerida
- Usuarios/Equipo: Desarrolladores de backend, ingenieros de datos o arquitectos de IA con capacidad para manejar librerías vía
npm,pipocargo. No requiere expertos en ML, pero sí programadores cómodos con formatos binarios y estructuras de datos. - Empresa/Departamentos: Organizaciones con una infraestructura de datos ya establecida que busquen optimizar costes de procesamiento y mejorar la calidad de la ingesta de datos para sus modelos de lenguaje.
Plan orientativo de implantación
Pasos necesarios y estimaciones
- Evaluación inicial (1-2 días): Mapeo de los formatos de origen predominantes en la empresa y verificación de si son PDFs basados en texto o escaneados (crucial para decidir si se necesita la capa de OCR externa).
- Prueba de concepto / PoC (1 semana): Integración de la librería en un entorno de desarrollo para medir latencias reales con documentos propios y comparar la calidad del Markdown resultante frente a soluciones previas como Pandoc o Unstructured.
- Configuración y personalización (1 semana): Desarrollo de la lógica para manejar los
assetsembebidos (imágenes/objetos) que Anydoc extrae pero que deben ser almacenados o referenciados en un sistema de archivos o cloud storage. - Despliegue y escalado (Continuo): Al ser una librería nativa en Rust, el despliegue es ligero (self-contained), lo que facilita el uso en contenedores Docker o funciones Serverless (AWS Lambda/Vercel) con tiempos de arranque mínimos.
Necesidades de formación del equipo
- Capacitación en el manejo del modelo de documento compartido de Anydoc para extraer metadatos específicos.
- Formación básica en Markdown estructurado (GFM) para asegurar que el output se alinee con los requisitos del "chunking" de su base de datos vectorial.
Perfiles necesarios
- Perfiles técnicos: Desarrolladores Senior en Rust (ideal) o Python/Node.js con experiencia en procesamiento de archivos.
- Personal externo: Consultores de arquitectura de datos si la ingesta masiva requiere orquestación compleja (Airflow, Temporal).
Retorno de la inversión (ROI)
- Tiempos: Reducción drástica del tiempo de inferencia y pre-procesamiento. Pasar de medianas de 500ms (herramientas basadas en Python/ML) a menos de 5ms por documento supone un ahorro directo en costes de computación de hasta un 90% en procesos masivos.
- KPIs: Latencia de conversión por documento, tasa de error de parseo (Anydoc ofrece errores tipificados muy útiles como
MalformedoEncrypted), y precisión en la recuperación de información (Retrieval Accuracy) gracias a la limpieza del Markdown.
Otros
Lo que más me gusta de Anydoc es su manejo de errores explícito; no falla de forma genérica, sino que te dice exactamente si el archivo está encriptado o malformado, lo cual es vital para pipelines de producción. Al usarlo, te das cuenta de que su mayor limitación actual es la falta de OCR nativo en la versión local, por lo que si tu repositorio documental es 80% papel escaneado, deberás complementar Anydoc con una solución de visión artificial o usar la versión Cloud de Firecrawl. En mi opinión profesional, es la herramienta más "limpia" arquitectónicamente que he visto en este nicho recientemente.
Instalación
- Para Node.js, utiliza el gestor de paquetes estándar ejecutando
npm install @firecrawl/anydoc. - En entornos Python, instala la librería mediante
pip install firecrawl-anydoc(recuerda que el paquete se importa simplemente comoanydoc). - Si prefieres usar la herramienta desde la terminal sin instalación previa, puedes ejecutar
npx @firecrawl/anydoc archivo.docx. - Para un uso recurrente en CLI, recomiendo la instalación global con
npm install -g @firecrawl/anydoc. - Si trabajas en entornos de navegador, existe una versión específica en WebAssembly disponible con
npm install @firecrawl/anydoc-wasm. - Checklist de pre-requisitos:
- Node.js v18+ o Python 3.8+.
- Si usas la versión de Rust, asegúrate de tener el toolchain de Cargo actualizado.
- Conexión a internet solo si planeas usar el motor de OCR hospedado.
Uso en el día a día
- Según mi experiencia es necesario entender que la detección de formato es automática basada en el contenido del archivo (magic bytes), no solo en la extensión. Esto es vital para procesar archivos renombrados incorrectamente.
- Al usarlo te das cuenta de que la función
to_markdownes la más eficiente para flujos rápidos, pero si necesitas manejar imágenes o metadatos complejos, es mejor usarto_document. - Mi experiencia me lleva a pensar que para el procesamiento de archivos CSV, lo más seguro es especificar el formato manualmente, ya que el motor de detección puede fallar al no tener cabeceras binarias claras.
- En mi opinión profesional, la integración como "Agent Skill" es el mayor valor añadido si trabajas con Claude Code o Cursor; basta con ejecutar
npx skills add firecrawl/anydoc.
Trucos de experto
- Aprovecha el parámetro
ocr="hosted"cuando trabajes con PDFs escaneados. Por defecto, AnyDoc no realiza OCR local para mantener la ligereza, pero esta opción delega el trabajo pesado a la API de Firecrawl sin configuración compleja. - Lo que más me gusta es la consistencia del Markdown generado; al usar un modelo de documento compartido, los encabezados y tablas se ven igual sin importar si la fuente es un .docx o un .pptx.
- Para flujos de automatización pesados, utiliza
to_markdown_bytesdirectamente sobre buffers de memoria para evitar operaciones de escritura/lectura en disco innecesarias. - Configura la variable de entorno
FIRECRAWL_API_KEYpara evitar límites de tasa (rate limits) si utilizas la conversión hospedada de forma intensiva.
Posibles problemas/incidencias
NeedsOcrError: Aparecerá siempre que intentes procesar un PDF que solo contiene imágenes sin activar la opciónhosted.ResourceLimitError: AnyDoc tiene límites de seguridad para prevenir ataques de "bomba de descompresión" o recursividad infinita en documentos maliciosos. Si trabajas con archivos extremadamente grandes, podrías alcanzar este límite.EncryptedError: La herramienta no puede procesar archivos protegidos con contraseña por diseño de seguridad.- Incompatibilidades: Aunque soporta la mayoría de formatos Office, los archivos extremadamente antiguos (anteriores a Office 2007 sin formato XML) pueden presentar errores de parseo o ser detectados como
UnsupportedError.
Otros
- Integración con IA: AnyDoc está optimizado para alimentar LLMs, entregando GitHub-Flavored Markdown (GFM) que es el formato que mejor interpretan modelos como GPT-4 o Claude.
- Rendimiento: Al estar escrito en Rust, la velocidad de conversión local es casi instantánea, superando a librerías basadas puramente en Python o JS.
Opinión inicial
Tras analizar la documentación técnica y legal de Anydoc (desarrollado por SideGuide Technologies Inc., operando como Firecrawl), mi opinión profesional es que nos encontramos ante una herramienta de bajo impacto de riesgo legal siempre que se utilice en su modalidad de librería local (Self-hosted/Open Source). A diferencia de otros servicios de conversión en la nube que procesan datos en servidores externos (normalmente en EE. UU. bajo jurisdicción de Delaware), la ejecución local de Anydoc garantiza que la empresa mantiene el control físico y lógico de la información, facilitando el cumplimiento con el RGPD desde el diseño. No obstante, si se opta por la versión API (Firecrawl Hosted), el impacto sube a medio/alto debido a la transferencia internacional de datos a una empresa estadounidense.
Principales recomendaciones
- Priorizar el uso de la librería local: Utilizar los bindings de Rust, Python o Node.js para que los documentos no salgan de la infraestructura de la empresa.
- Auditoría de Ingesta: Asegurar que los documentos a procesar no contengan datos de categorías especiales (salud, religión, orientación sexual) sin haber realizado previamente una Evaluación de Impacto (EIPD), ya que el procesamiento automatizado masivo puede escalar el riesgo.
- Control de Licencia MIT: Aunque la licencia es muy permisiva, es obligatorio mantener el aviso de copyright de Sideguide Technologies Inc. en cualquier redistribución del software.
- Diferenciación de servicios: Si se activa la funcionalidad de OCR a través de la API de Firecrawl, se debe firmar un Acuerdo de Encargo de Tratamiento (DPA) con el proveedor.
Ley de Inteligencia Artificial (AI Act)
- Calificación: Anydoc, en su versión de librería local, no se considera un "sistema de IA de alto riesgo" per se, sino una herramienta de infraestructura y pre-procesamiento de datos (ETL).
- Transparencia: Según el AI Act, si esta herramienta se usa para alimentar un modelo de IA que interactúa con humanos, la empresa española debe informar de que los datos han sido procesados automáticamente, aunque Anydoc funcione de forma determinista (sin modelos probabilísticos en su núcleo Rust).
- Uso de modelos: Si se utiliza la versión hosted con OCR (que sí emplea modelos de visión artificial), se deben aplicar las obligaciones de vigilancia humana y calidad de los conjuntos de datos.
Privacidad y protección de datos
- Responsabilidades: En la versión local, la empresa española es el único Responsable del Tratamiento. En la versión API, la empresa es Responsable y Firecrawl actúa como Encargado del Tratamiento.
- Ubicación de los datos: En uso local, la ubicación es el servidor de la empresa (España/UE). En uso API, los datos se procesan en servidores de Firecrawl (SideGuide Technologies, Inc.), generalmente ubicados en EE. UU.
- Transferencia internacional: El uso de la API implica una transferencia a EE. UU. Se requiere verificar si el proveedor está adherido al Data Privacy Framework (DPF) o firmar Cláusulas Contractuales Tipo (SCCs).
- Derechos ARCO: La empresa debe garantizar que puede localizar y eliminar la información en los outputs de Markdown resultantes si un usuario ejerce sus derechos.
Propiedad intelectual
- Propiedad de datos: La empresa española retiene la propiedad total de los archivos originales subidos y de los metadatos.
- Propiedad del resultado: Según los términos de licencia y la normativa de la UE, el resultado del procesamiento (el Markdown generado) pertenece a la empresa que opera la herramienta, ya que la transformación no añade una "creación intelectual" por parte del software, sino una conversión técnica.
- Software: El motor está bajo licencia MIT, lo que permite modificarlo e integrarlo en productos comerciales propios sin pagar regalías.
Usos y prohibiciones
- Usos admitidos: Indexación de documentos internos, creación de bases de datos para RAG, automatización de flujos de trabajo legales y administrativos.
- Usos prohibidos: Según los términos de servicio de Firecrawl, está prohibido usar sus herramientas para vigilancia gubernamental, verificación de antecedentes penales o cualquier actividad que infrinja leyes de privacidad como el RGPD o CCPA. No debe usarse para eludir medidas tecnológicas de protección (DRM) de documentos protegidos por derechos de autor de terceros.
Seguridad y certificaciones
- Seguridad: Al estar escrito en Rust, ofrece garantías nativas de seguridad de memoria (memory safety), lo que reduce drásticamente las vulnerabilidades tipo "buffer overflow" comunes en otros conversores (como los basados en C++).
- Certificaciones: La librería local no posee certificaciones ISO/IEC por sí misma al ser código abierto. La seguridad recae en la implementación que haga la empresa española.
Otros
- Consistencia Legal: Una ventaja clave es la detección de formato por bytes. Desde el punto de vista de seguridad IT/Compliance, esto mitiga ataques de "File Upload" donde un atacante intenta camuflar scripts maliciosos bajo extensiones de oficina falsas.